介绍
Go 语言是一种静态、编译型、并发型的编程语言。它具有强类型、垃圾回收、快速编译等特性,属于 C 系语言的一种 编译型 vs 解释型
-
编译型语言
优点:编译器一般会有预编译的过程对代码进行优化。因为编译只做一次,运行时不需要编译,所以编译型语言的程序执行效率高。可以脱离语言环境独立运行。
缺点:编译之后如果需要修改就需要整个模块重新编译。编译的时候根据对应的运行环境生成机器码,不同的操作系统之间移植就会有问题,需要根据运行的操作系统环境编译不同的可执行文件。
-
解释型语言
优点:有良好的平台兼容性,在任何环境中都可以运行,前提是安装了解释器(虚拟机)灵活,修改代码的时候直接修改就可以,可以快速部署,不用停机维护。
缺点:每次运行的时候都要解释一遍,性能上不如编译型语言。
-
混合型语言
既然编译型和解释型各有缺点就会有人想到把两种类型整合起来,取其精华去其糟粕。就出现了半编译型语言。比如 C#,C#在编译的时候不是直接编译成机器码而是中间码,.NET 平台提供了中间语言运行库运行中间码,中间语言运行库类似于 Java 虚拟机。.net 在编译成 IL 代码后,保存在 dll 中,首次运行时由 JIT 在编译成机器码缓存在内存中,下次直接执行。
源码文件

1、命令源码文件:
声明自己属于 main 代码包、包含无参数声明和结果声明的 main 函数。命令源码文件被安装以后,GOPATH 如果只有一个工作区,那么相应的可执行文件会被存放当前工作区的 bin 文件夹下;如果有多个工作区,就会安装到 GOBIN 指向的目录下。
2、库源码文件
库源码文件就是不具备命令源码文件上述两个特征的源码文件。存在于某个代码包中的普通的源码文件。 库源码文件被安装后,相应的归档文件(.a 文件)会被存放到当前工作区的 pkg 的平台相关目录下。
3、测试源码文件
名称以 test.go 为后缀的代码文件,并且必须包含 Test 或者 Benchmark 名称前缀的函数。
输入输出
fmt 中输入函数 Scanln
1. 使用"&"获取变量的内存地址(即取变量内存地址的运算符),通过键盘输入为变量指向的内存地址赋初值。
2. fmt.Scanln是一个阻塞的函数,如果它获取不到数据就会一直阻塞哟。
3. fmt.Scanln可以接收多个参数,用户输入参数默认使用空格或者回车换行符分割输入设备传入的参数,直到接收所有的参数为止
fmt 中的输出函数 Println(ln 表示自动换行)
1. Println格式使用其操作数的默认格式,并写入标准输出。
2. 始终在操作数之间添加空格,并追加换行符。
3. 它返回写入的字节数和遇到的任何写入错误。
注意,如果需要输出如%s,%T 这种类型,则需要使用 Printf,这个跟 C 是类似的
1fmt.Printf("type: %T",str)
数据结构
数据类型
数类型
uint8 无符号 8 位整型 (0 到 255)
uint16 无符号 16 位整型 (0 到 65535)
uint32 无符号 32 位整型 (0 到 4294967295)
uint64 无符号 64 位整型 (0 到 18446744073709551615)
int8 有符号 8 位整型 (-128 到 127)
int16 有符号 16 位整型 (-32768 到 32767)
int32 有符号 32 位整型 (-2147483648 到 2147483647)
int64 有符号 64 位整型 (-9223372036854775808 到 9223372036854775807)
float32 和 float64 范围分别为 3.4e38 和 1.8e308
complex64 和 complex128
字符类型
uint8 类型,或者叫 byte 型,代表一个 ASCII 码字符。
rune 类型,代表一个 UTF-8 字符。
rune 类型是 int32 的别名,用于表示一个 Unicode 码点(Unicode code point)。每个rune对应一个 Unicode 字符,可以表示任何语言的字符(包括中文、表情符号等)
Go 的字符串默认以 UTF-8 编码存储。当遍历字符串时,若用 for range,会自动按 rune 为单位迭代,而非字节:
1s := "Hello 世界"
2for _, r := range s {
3// r 的类型是 rune
4fmt.Printf("%c ", r)
5}
6// 输出: H e l l o 世 界
这里是对于 range 的解释:golang 中使用 for range 遍历字符串时常遇到的 bug,byte 和 rune 类型,源码分析 - Harven - 博客园
数组和切片
数组(Array)和切片(Slice)的区别其实是数组在定义的时候已经规定好了长度,而切片并没有规定长度 数组是需要指定初始化长度(或者叫做容量)的序列,在定义时可以直接设置初始值,如果不设置,初始值为默认值 切片是一个拥有相同类型元素的可变长度的序列,可以通过 append 函数添加元素
代码书写
切片可以用内置函数 make 来创建,这也是你创建动态数组的方式。
make 函数会分配一个元素为零值的数组并返回一个引用了它的切片:
1a := make([]int, 5) // len(a)=5
要指定它的容量,需向 make 传入第三个参数
1arr := [5]int{0, 1, 2, 3, 4} //创建一个数组
2s1 := arr[0:3] //创建一个子切片,[0:3)左闭右开
3s2 := make([]int, 3, 4) //创建一个切片,长度为3,初始元素为0,容量为4
4s1 = append(s1, 8) //追加一个元素
5s2 = append(s2, 1) //追加一个元素
6//切片比较好的创建方式为make([]int,0,cap)
-
子切片
通过[start:end]来获得子切片,arr[start:end]获取的是
[start,end)之间的元素,左闭右开 arr[:end]获得[0,end)之间的元素 arr[start:]获得[start,len(arr))之间的元素 子切片与原切片共享底层数组 -
理解 slice
实际上是 Go 中特殊的 ArrayList,但是没有插入和删除的操作,只有 append 操作,下面稍微写了一下对于 slice 的 insert 和 delete,在这其中使用了 copy 函数:当我们在 Go 语言中需要将一个切片的内容复制到另一个切片时,可以使用内置的 copy()函数,copy()函数用于将源切片中的元素复制到目标切片中。 slice 的零值是 nil,通过[]int 这种方式来创建切片时首先会创建一个对应的底层数组
 1//实现指定位置插入元素
 2func insert(slice []int,value int,index int) []int {
 3	slice = append(slice, 0) //扩展一个空间
 4	copy(slice[index+1:],slice[index:]) //向后移动
 5	slice[index] = value //插入元素
 6	return slice
 7}
 8//实现指定位置删除元素
 9func delete(slice []int,index int) []int {
10	copy(slice[index:],slice[index+1:]) //向前移动
11	return slice[:len(slice)-1] //删除最后一个元素
12}
练习切片的一个小程序,通过灰度图展示公式
 1package main
 2
 3import "golang.org/x/tour/pic"
 4
 5func Pic(dx, dy int) [][]uint8 {
 6	ans := make([][]uint,dy)
 7	for y:=0;y<dy;y++{
 8		row := make([]uint8,dx)
 9		for x:=0;x<dx;x++{
10			row[x] = uint8(x%(y+1))
11		}
12		ans[y]=row
13	}
14	return ans
15}
16
17func main() {
18	pic.Show(Pic)
19}
字符串
字符串用"abc"表示,单个字符用'a'表示
字符串可以通过索引访问字符
1s:="abcde"
2print(s[0])
字符串可以通过切片访问连续字符
1s:="abcde"
2print(s[0:3])
统计字符串的个数要用特殊的方法
1s:="abcde"
2print(utf8.RuneCountInString(s))}
将字符编码转换为字符
1s:="abcde"
2print(string(s[1]))
遍历字符串的每一个字符
1s:="我爱你中国"
2cs:=[]rune(s)
3for_,ch:=range cs{
4	fmt.Println(string(ch))
5}
使用 buffer 累加字符串
1var bf bytes.Buffer
2for i:=0;i<10;i++{
3	fmt.Fprintf(&bf,"a%d",i)
4}
5s:=bf.String()
6fmt.Println(s)
指针
&符号会【生成】一个指向其作用对象的指针。*符号表示指针指向的【底层的值】
 1package main
 2import "fmt"
 3func main() {
 4	i, j := 42, 2701
 5	p := &i         // p为i的指针
 6	fmt.Println(*p) // 通过指针显示的是i的值
 7	*p = 21         // 通过指针修改的是i的值
 8	fmt.Println(i)
 9	p = &j         // 将p改为j的指针
10	*p = *p / 37   // 通过指针操作的是j的值,除以37的结果重新通过指针赋给j
11	fmt.Println(j)
12}
结构体定义
定义类型
定义类型的不同方式,使用也不相同
1// BigServer type A=B
2type BigServer = server
3// SmellServer type A B
4type SmellServer server
5
6service1 := SmellServer{}
7service2 := BigServer{}
8server(service1).open()
9service2.open()
初始化
Go 没有构造函数,所以 new 直接分配内存然后把内存都置 0
1man1 := Person{name: "李四"}
2man1.Walk(man1.name)
3man2 := new(Person)
4man2.name = "王五"
5man2.Walk(man2.name)
方法接收器
用于定义结构体对应的方法(也可以为非结构体类型声明方法)
只能为在同一个包中定义的接收者类型声明方法,而不能为其它别的包中定义的类型(包括 int 之类的内置类型)声明方法
 1// 结构体接收器
 2func (p Person) ChangeName(newName string) {
 3   p.name = newName
 4}
 5// 指针接收器
 6func (p *Person) ChangeAge(newAge int) {
 7   p.age = newAge
 8}
 9// 结构体接收器,内容不会改变
10man1.ChangeName("赵六")
11// 指针接收器,内容会改变,我直接遇事不决用指针
12man1.ChangeAge(30)
13fmt.Println(man1)
哈希表
Go 之旅中的一个练习,用的是比较简单的 map,实现 WordCount。它应当返回一个映射,其中包含字符串 s 中每个“单词”的个数。 函数 wc.Test 会为此函数执行一系列测试用例,并输出成功还是失败
 1package main
 2
 3import (
 4	"golang.org/x/tour/wc"
 5	"strings"
 6)
 7func WordCount(s string) map[string]int {
 8	v := strings.Fields(s) //Field函数直接分割
 9	n := len(v)
10	x := make(map[string]int)
11	for i:=0;i<n;i++ {
12		x[v[i]]++
13	}
14	return x
15}
16
17func main() {
18	wc.Test(WordCount)
19}
控制结构
for 类似 while 的无限循环 fori 一般的按照下标循环 forr 最为特殊的 range 遍历,可以用于 map 遍历
1for i := 0; i < len(arr); i++ {
2fmt.Printf(" index = %d,number = %d \n", i, arr[i])
3}
4for index, value := range arr{
5fmt.Printf(" index = %d,number = %d \n", index, value)
6}
if-else:没什么可以记录的,跟其他的语言一样的
函数调用
Go 语言选择了传值的方式,无论是传递基本类型、结构体还是指针,都会对传递的参数进行拷贝
无需声明原型
支持不定变参
支持多返回值
支持命名返回参数
函数也是一种类型,一个函数可以复制给变量;可以作为参数传递给其他函数
不支持嵌套(一个包不能有重名的函数)
不支持重载
不支持默认参数
整数与数组类型
如下所示的函数 myFunction 接收了两个参数,整型变量 i 和数组 arr,这个函数会将传入的两个参数的地址打印出来,在最外层的主函数也会在 myFunction 函数调用前后分别打印两个参数的地址,最后的结果 main 函数中的参数地址与 myFunction 中的地址完全不同,所以能够证明Go 语言的整型和数组类型都是值传递的
 1func myFunction1(i int, arr [2]int) {
 2	fmt.Printf("in my_funciton - i=(%d, %p) arr=(%v, %p)\n", i, &i, arr, &arr)
 3}
 4
 5func main() {
 6	i := 30
 7	arr := [2]int{66, 77}
 8	fmt.Printf("before calling - i=(%d, %p) arr=(%v, %p)\n", i, &i, arr, &arr)
 9	myFunction1(i, arr)
10	fmt.Printf("after  calling - i=(%d, %p) arr=(%v, %p)\n", i, &i, arr, &arr)
11}
结构体与指针类型
- 传递结构体时:会拷贝结构体中的全部内容
- 传递结构体指针时:会拷贝结构体指针
 1func myFunction2(a MyStruct, b *MyStruct) {
 2    a.i = 31
 3    b.i = 41
 4    fmt.Printf("in my_function - a=(%d, %p) b=(%v, %p)\n", a, &a, b, &b)
 5}
 6func main() {
 7	a := MyStruct{i: 30}
 8	b := &MyStruct{i: 40}
 9	fmt.Printf("before calling - a=(%d, %p) b=(%v, %p)\n", a, &a, b, &b)
10	myFunction2(a, b)
11	fmt.Printf("after calling  - a=(%d, %p) b=(%v, %p)\n", a, &a, b, &b)
12}
方法与函数
- 方法 (
func (c *Context) String):- 方法的第一个参数是一个接收者(receiver),即
c *Context,表示该方法属于Context类型。 - 方法的调用方式是通过类型的实例来调用,例如
context.String(...),其中context是Context类型的一个实例。 - 表达的是
String操作是Context类型的一部分,是Context对象的一个行为。 - 更适合表示“某种类型的实例应该具备的行为”。
- 方法的第一个参数是一个接收者(receiver),即
- 函数 (
func String(c *Context)):- 一个普通的函数,它的参数是
c *Context,表示函数接收一个*Context类型的参数。 - 函数的调用方式是直接调用,并传入参数,例如
String(context, ...),参数列表名称在前,类型在后,可以有多返回值,返回值也可以有名称 - 是独立于
Context类型的一个函数,只是恰好接受一个Context类型的参数。 - 更适合表示“一般性的操作或工具函数”,而不是某种类型的固有行为。
- 一个普通的函数,它的参数是
方法与指针重定向
1func (v *Vertex) Scale(f float64) {
2	v.X = v.X * f
3	v.Y = v.Y * f
4}
5
6func ScaleFunc(v *Vertex, f float64) {
7	v.X = v.X * f
8	v.Y = v.Y * f
9}
比较前两个程序,你大概会注意到带指针参数的函数必须接受一个指针:
1var v Vertex
2ScaleFunc(v, 5)  // 编译错误!
3ScaleFunc(&v, 5) // OK
而接收者为指针的的方法被调用时,接收者既能是值又能是指针:
1var v Vertex
2p := &Vertex{4, 3}
3p.Scale(3) //OK
4(*p).Scale(8) //OK
对于语句 v.Scale(5) 来说,即便 v 是一个值而非指针,带指针接收者的方法也能被直接调用。 也就是说,由于 Scale 方法有一个指针接收者,为方便起见,Go 会将语句 v.Scale(5) 解释为 (&v).Scale(5)。
反之同理,接受一个值作为参数的函数必须接受一个指定类型的值,而以值为接收者的方法被调用时,接收者既能为值又能为指针,这种情况下,方法调用 p.Abs() 会被解释为 (*p).Abs(),其实就是遇到不同情况自动转换。
接口
接口是计算机系统中多个组件共享的边界,不同的组件能够在边界上交换信息。如下图所示,接口的本质是引入一个新的中间层,调用方可以通过接口与具体实现分离,解除上下游的耦合,上层的模块不再需要依赖下层的具体模块,只需要依赖一个约定好的接口。
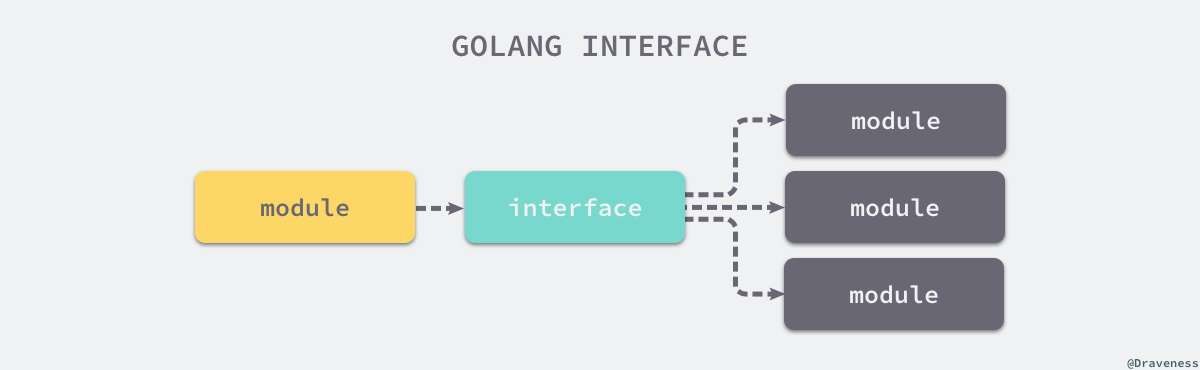
在 Java 中:实现接口需要显式地声明接口并实现所有方法,在接口中不仅可以定义方法签名,还可以定义变量,这些定义的变量可以直接在实现接口的类中使用
 1public interface MyInterface {
 2    public String hello = "Hello";
 3    public void sayHello();
 4}
 5
 6public class MyInterfaceImpl implements MyInterface {
 7    public void sayHello() {
 8        System.out.println(MyInterface.hello);
 9    }
10}
在 Go 中:实现接口的所有方法就隐式地实现了接口,但是在接口中我们只能定义方法签名,不能包含成员变量
 1type error interface {
 2	Error() string
 3}
 4type RPCError struct {
 5	Code    int64
 6	Message string
 7}
 8func (e *RPCError) Error() string {
 9	return fmt.Sprintf("%s, code=%d", e.Message, e.Code)
10}
Java 中的类必须显式地声明实现的接口,与 Java 不同的是 Go 语言中接口的实现都是隐式的,我们只需要实现 Error() string 方法就实现了 error 接口
接口方法
接口就是规定了一个需要实现的方法列表,在 Go 语言中一个类型只要实现了接口中规定的所有方法,那么我们就称它实现了这个接口
我们定义的 Singer 接口类型,它包含一个 Sing 方法。
1type Singer interface {
2	Sing()
3}
然后有一个 Bird 结构体
1type Bird struct {}
因为 Singer 接口只包含一个 Sing 方法,所以只需要给 Bird 结构体添加一个 Sing 方法就可以满足 Singer 接口的要求。
1// Sing Bird类型的Sing方法
2func (b Bird) Sing() {
3	fmt.Println("汪汪汪")
4}
为什么要用接口呢,因为有时不止一个类型需要实现这个方法,可能有多个结构体需要 Sing() 这个方法,这时就可以使用接口类型,把所有会叫的动物当成 Singer 类型来处理
 1package main
 2
 3import "fmt"
 4
 5type Sayer interface {
 6    Say()
 7}
 8type Cat struct {
 9}
10
11type Dog struct{}
12
13func (c *Cat) Say() {
14    fmt.Println("cat miao")
15}
16func (d *Dog) Say() {
17    fmt.Println("dog woof")
18}
19func Hungry(s Sayer) {
20    s.Say()
21}
22
23func main() {
24    var c Cat
25    var d Dog
26    Hungry(&c)
27    Hungry(&d)
28}
Stringer 是 fmt 包中定义的 Stringer 是最普遍的接口之一,是一个可以用字符串描述自己的类型,任何实现了 String() string 方法的类型都隐式满足该接口。fmt 包(还有很多包)都通过此接口来打印值,可以规范化对应值的输出
 1package main
 2
 3import "fmt"
 4
 5type IPAddr [4]byte
 6
 7// TODO: 为 IPAddr 添加一个 "String() string" 方法。
 8func (I IPAddr) String() string{
 9	return fmt.Sprintf("%v.%v.%v.%v",I[0],I[1],I[2],I[3])
10}
11func main() {
12	hosts := map[string]IPAddr{
13		"loopback":  {127, 0, 0, 1},
14		"googleDNS": {8, 8, 8, 8},
15	}
16	for name, ip := range hosts {
17		fmt.Printf("%v: %v\n", name, ip)
18	}
19}
与 fmt.Stringer 类似,error 类型是一个内建接口
1type error interface {
2    Error() string
3}
类似的还有,sort 接口,json 序列化,io 读写,以及 http 的请求处理 rot13Reader 的实现,一个接口组合的实现
 1package main
 2
 3import (
 4	"io"
 5	"os"
 6	"strings"
 7)
 8
 9type rot13Reader struct {
10	r io.Reader
11}
12
13func rot13(c byte) byte {
14	switch {
15	case c >= 'A' && c <= 'Z':
16		return 'A' + (c-'A'+13)%26
17	case c >= 'a' && c <= 'z':
18		return 'a' + (c-'a'+13)%26
19	default:
20		return c
21	}
22}
23
24func (r *rot13Reader) Read(b []byte) (n int, err error) {
25	// 要调用底层的Read
26    n, err = r.r.Read(b)
27    for i := 0; i < n; i++ {
28        b[i] = rot13(b[i])
29    }
30    return n, err
31}
32
33func main() {
34	s := strings.NewReader("Lbh penpxrq gur pbqr!")
35	r := rot13Reader{s}
36	io.Copy(os.Stdout, &r)
37}
图像生成器
 1package main
 2
 3import (
 4	"fmt"
 5	"golang.org/x/tour/pic"
 6	"image"
 7	"image/color"
 8)
 9
10type Image struct{
11	Width int
12	Height int
13}
14// Bounds image.Rectangle
15func (img Image)Bounds() image.Rectangle{
16	return image.Rect(0,0,img.Width,img.Height)
17}
18
19// Color color.RGBModel
20func (img Image) ColorModel() color.Model{
21	return color.RGBAModel
22}
23// At  color.Color
24func (img Image) At(x,y int) color.Color{
25	v := uint8(x^y)
26	return color.RGBA{v,v,255,255}
27}
28
29func main() {
30	m := Image{256,256}
31	pic.ShowImage(m)
32}
错误(error)
Go 程序使用 error 值来表示错误状态。通常函数会返回一个 error 值,调用它的代码应当判断这个错误是否等于 nil 来进行错误处理。
 1package main
 2
 3import (
 4	"fmt"
 5	"math"
 6)
 7type ErrNegativeSqrt struct{
 8	Value float64
 9}
10
11func Sqrt(x float64) (float64, error) {
12	if x<0 {
13		return x , ErrNegativeSqrt{Value: x}
14	}else {
15		return math.Sqrt(x),nil
16	}
17}
18// 重写Error方法,输出更多错误提示信息
19func (e ErrNegativeSqrt) Error() string{
20	return fmt.Sprintf("cannot Sqrt negative number: %v",float64(e))
21}
22
23func main() {
24	fmt.Println(Sqrt(2))
25	fmt.Println(Sqrt(-2))
26}
接口值
接口类型的值可以是任意一个实现了该接口的类型值,所以接口值除了需要记录具体值之外,还需要记录这个值属于的类型。也就是说接口值由“类型”和“值”组成。
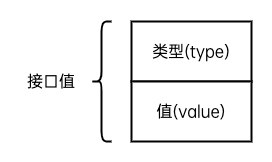
接口值(Interface Value) 本质上是一个动态容器,它可以持有任意具体类型的值,并在运行时记录类型信息,隐式接口从接口的实现中解耦了定义,这样接口的实现可以出现在任何包中,无需提前准备
nil 接口值既不保存值也不保存类型,为 nil 接口调用方法会产生运行时错误,因为接口的元组内并未包含能够指明该调用哪个具体方法的类型
指定了零个方法的接口值被称为空接口,空接口可保存任何类型的值,空接口被用来处理未知类型的值
类型断言
类型断言是一种可以从接口值中提取其动态类型具体值的方法,给一个什么值,他就变成对应的类型
该语句断言接口值 i 保存了具体类型 Type,并将其底层类型为 Type 的值赋予变量 t,如果未保存,那么该语句就会触发 panic
1 t := i.(T)
为了 判断 一个接口值是否保存了一个特定的类型,类型断言可返回两个值:其底层值以及一个报告断言是否成功的布尔值。
1 t, ok := i.(T)
若 i 保存了一个 T,那么 t 将会是其底层值,而 ok 为 true
否则,ok 将为 false 而 t 将为 T 类型的零值,程序并不会产生 panic
类型选择
类型选择 是一种按顺序从几个类型断言中选择分支的结构,它们针对给定接口值所存储的值的类型进行比较
 1func Describe(s Shape) {
 2    switch v := s.(type) {
 3    case Circle:
 4        fmt.Printf("圆形,半径: %v\n", v.Radius)
 5    case Rectangle:
 6        fmt.Printf("矩形,长: %v, 宽: %v\n", v.Width, v.Height)
 7    default:
 8        fmt.Println("未知形状")
 9    }
10}
11
12func main() {
13    Describe(Circle{Radius: 3})    // 输出:圆形,半径: 3
14    Describe(Rectangle{4, 5})      // 输出:矩形,长: 4, 宽: 5
15}
闭包(closure)
闭包(closure)是指一个函数可以捕获并引用其外部作用域中的变量,即使在这些变量的作用域已经结束之后,换句话说,该函数被“绑定”到了这些变量。闭包的实现依赖于函数本身以及它所引用的环境
1i := 13
2a := func() {
3    fmt.Println("i = ", i)
4}
5a()
延迟绑定:闭包捕获的是变量的引用,而不是它在循环中每次迭代的值
 1func Delay() {
 2    fns := make([]func(), 0, 10)
 3    for i := 0; i < 10; i++ {
 4       fns = append(fns, func() {
 5          fmt.Println("i = ", i)
 6       })
 7    }
 8    //执行的时候i = 10,因为闭包捕获的是变量i的引用,而不是值
 9    //因此在循环中使用闭包时需要小心处理
10    //??为什么我这里是i从0-9,好诡异啊
11    for _, fn := range fns {
12       fn()
13    }
14}
杂项记录
查看对应变量的类型
1//使用%T
2fmt.Printf("type: %T", value)
3
4//使用reflect下的Typeof,要引入reflect包
5fmt.Println(reflect.Typeof(value))
输出其命令行参数
 1package main
 2
 3import (
 4"fmt"
 5"os"
 6)
 7
 8func main() {
 9fmt.Println("Hello, World!")
10var s, sep string
11for _, arg := range os.Args[0:] { //输出目标文件命令的名字
12s += sep + arg
13sep = " "
14}
15//for i := 1; i < len(os.Args); i++ {
16// s += sep + os.Args[i]
17// sep = " "
18//}
19fmt.Println(s)
20}
OK 的使用
在 Go 语言中,ok 通常与 map 结合使用,用于判断某个键(key)是否存在于 map 中,是 Go 中一种常见的“安全读取”模式。
通过第二个返回值 ok(布尔类型)可以判断键是否存在:
1    m := map[string]int{"apple": 5, "banana": 3}
2
3    // 检查键是否存在
4    value, ok := m["apple"]
5    if ok {
6        fmt.Println("apple 存在,值是", value)
7    } else {
8        fmt.Println("apple 不存在")
9    }
在练习 LeetCode 的时候也看到有高级的语句记录了下来,对于 ok 在 if 中的使用含义,经常在 map 中使用:
1func learnErrorHandling() {
2// ", ok"用来判断有没有正常工作
3m := map[int]string{3: "three", 4: "four"}
4if x, ok := m[1]; !ok { // ok 为false,因为m中没有1
5fmt.Println("no one there")
6} else {
7fmt.Print(x) // 如果x在map中的话,x就是那个值喽。
8}
9}
上述代码中,在 if 语句中,ok这个 bool 变量的含义是,如果其中有1这个 key,那么其 value 赋值给x然后令 ok 为 true,如果没有则令 ok 为 false
引用包时出错
包在之后的代码中并未引用,可以通过在包名前加_进行匿名引用
定义变量
var 后面定义有默认类型,如果不想按照默认类型来的话,就需要自己写 go 是强类型语言,不做任何类型转换 或者直接:=进行赋值
1var a  = 13 // 默认为int
2var b uint =15
3a := 13
求 string 的长度
len()函数求出来的是字节的长度,而不是字符长度
应该用utf8.RuneCountInString("你好")进行求解
对二维数组进行排序
这里的 slices.SortFunc 通过传入一个比较函数(func(p, q []int) int)来实现对 intervals 进行排序
比较函数:func(p, q []int) int。它对两个元素 p 和 q 进行比较。
- 如果返回值
< 0,表示p应排在q之前。 - 如果返回值
> 0,表示q应排在p之前。 - 如果返回值
= 0,表示p和q的顺序无所谓。
1slices.SortFunc(intervals, func(p, q []int) int { return p[0] - q[0] })